

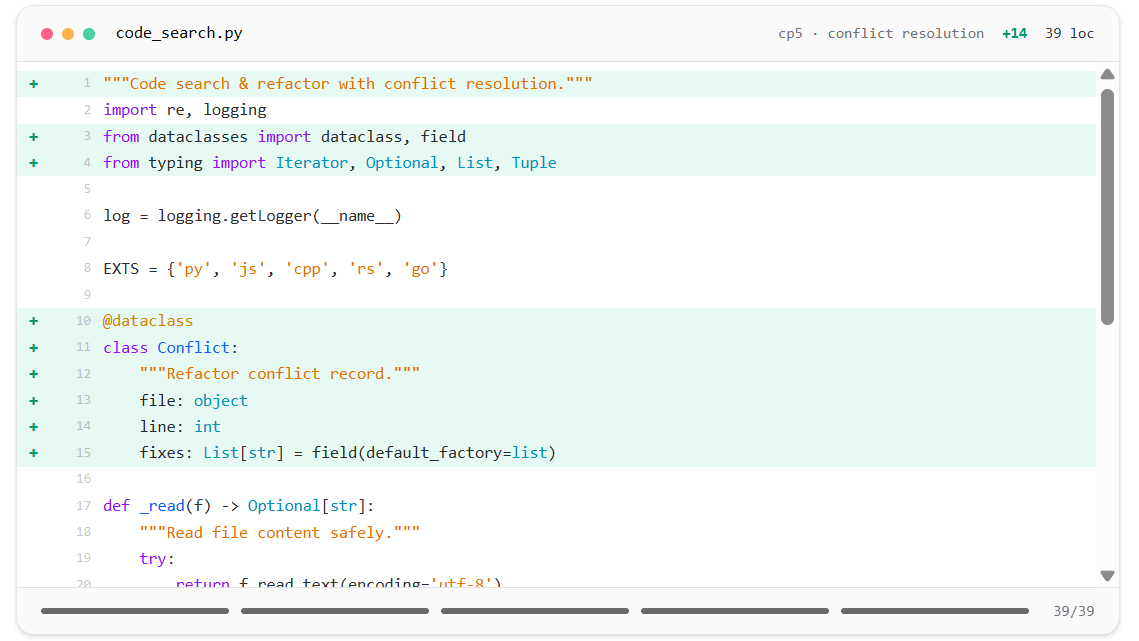
AIにプログラムを作成させると短時間で動作するコードを得られますが、機能の追加を繰り返すうちに古い処理との整合性が崩れたりコードが複雑になったりすることがあります。こうした問題を調べるために開発され、AI自身が作ったコードに新しい仕様を段階的に追加させながら機能の維持や品質の変化を測定するベンチマークが「SlopCodeBench」です。
Claude Codeの「次回から表示しない」でパスワードが流出する恐れ、GitHubで2539件の秘密情報が見つかる
AnthropicのAIコーディングツール「Claude Code」でコマンドの実行を許可する際に「次回から表示しない」を選ぶと、コマンドに含まれるパスワードなどの秘密情報まで設定ファイルに保存される問題が明らかになりました。セキュリティ企業のApiiroがGitHubを調査したところ、公開リポジトリ1994件から2539件の秘密情報が発見されたとのことです。
15分の空き時間を重ねて作ったフォント「Inter」がMozillaやGitHubで使用されるようになるまで
ウェブサイトで使用されるフォントは見やすさや操作しやすさを左右する非常に重要な要素です。正しいフォントを使うことによって人の気分を良くすることもできるため、ウェブサービスやウェブサイトは使うフォントに対して慎重になりますが、Firefoxを開発するMozillaはブランドリフレッシュの一部として「Inter」というオープンソースフォントを使用することにしました。実はInterはウェブデザイナーによって空き時間に作られたフォントだということで、開発者がどのように開発が行われたのか、Interの何が優れているのかを明かしています。
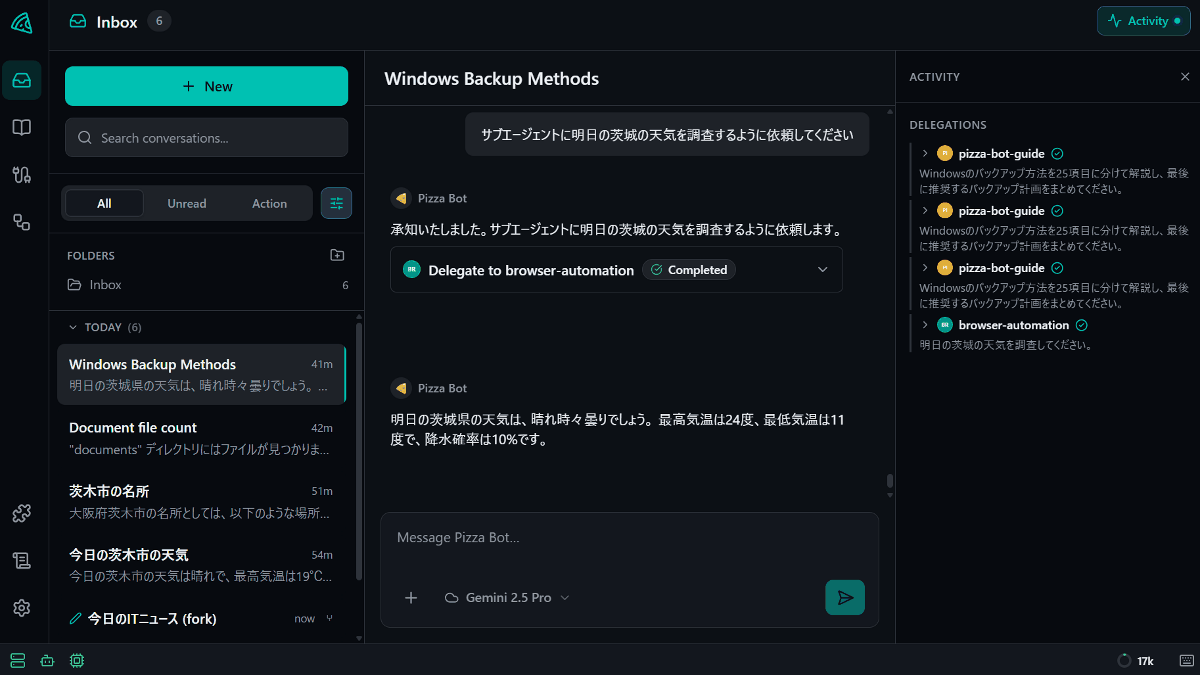
バックグラウンドで動作するAIエージェント用のメールっぽい受信箱「Pizza Bot」、Windows/macOS/Linuxに対応したセルフホスト型のデスクトップアプリでローカルAIモデルなどあらゆるAIモデルに対応して通知によるアクション管理が可能
複数のAIエージェントに作業を依頼する場合、途中の承認状態に気付かず作業が中断したり、作業が終了したことに気付かず次の指示待ちで放置されるなど作業効率が悪くなる場合があります。こうした無駄を無くすためAIエージェントをバックグラウンドで実行し、作業完了の通知や承認待ちの依頼をメールのような受信箱にまとめて管理できるほか、Windows・macOS・LinuxやローカルAIモデルにも対応する無料アプリが「Pizza Bot」です。
ゴミ屋敷化 - 橋本商会
人間が投稿する場所に、APIを使ったbotの自動投稿が混ざると居心地が悪くなる現象の事shokai 少しなら良い 新規ページがどんどん自動作成されると、そのWiKiは死ぬ 自動作成される新規ページの質は関係ない 投稿の比率が関係している気がする どうも脳内で持っている情報構成と、WiKi上のデータとの齟齬が大きくなると良くないようだ ページを探す速度が下がる 自分以外の他のメンバーがページを作る
アカデミックハラスメント情報資料室
全国の大学や研究機関におけるアカデミックハラスメント情報の収集と発信をめざします。収集した資料とハラスメント事例の概要公開を順次行うとともに、必要に応じて関連する当事者や(将来の)被害者への特定開示も行い、新たなハラスメントの発生を防ぐとともに当該組織へのハラスメント体質改善を促します。また将来的にはハラスメント事案の相談受付、ハラスメントレベルのランキング化や個別事案への第3者機関による介入方策の検討も進めます。
Google DeepMindがAIでコードを検証する「AlphaProof Code」を使ってSignalプロトコルの安全性の形式的検証に成功
Google DeepMindがソフトウェアの検証を行うためのマルチエージェントAIフレームワーク「AlphaProof Code」を発表しました。研究チームはAlphaProof Codeを用いて、Googleメッセージなどの暗号通信に使用されている「Signalプロトコル」が十分なセキュリティ保護機能を備えていることを数学的に証明することに成功しています。
約10年間見逃されていたOpenSSHの脆弱性「*sshole」が発覚、257文字以上のパスワードでログイン禁止アカウントを突破可能に
Linuxでリモートログインに使われるOpenSSHに、特定の条件下で正しいパスワードを知らなくてもログインできてしまう脆弱(ぜいじゃく)性「*sshole(CVE-2026-123158)」が発見されました。影響を受けるのはAlpine Linuxなどを利用する一部のシステムで、257バイト以上のパスワードを入力するだけで、本来はパスワードによるログインが禁止されているアカウントにアクセスできる可能性があります。
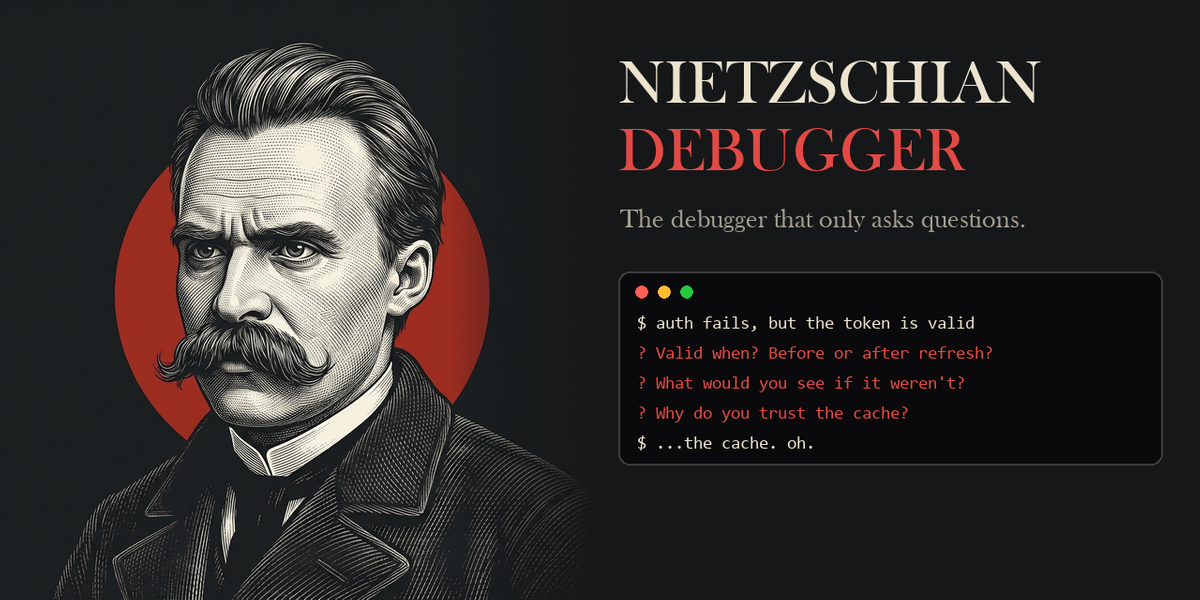
AIが答えを教える代わりにあえて質問攻めにすることで開発者を鍛えるデバッグツール「Nietzschian Debugger」
プログラムの不具合をAIに相談すると修正方法を教えてくれるのが一般的ですが、あえて答えを教えずに質問を繰り返すデバッグツール「Nietzschian Debugger」がGitHubで公開されています。開発者自身に不具合の原因を考えさせることで問題解決能力を鍛えるという、AIへの依存を減らすことを目指したツールとなっています。
Claude Code v2.1.322〜v2.1.323 の主要アップデート - Code Mode の追加と Bash 権限チェック・サンドボックスの修正 | DevelopersIO
Claude Code v2.1.323 は 294 件の変更を含む大型アップデートです。ツール呼び出しを JavaScript で書く実験的な Code Mode が加わり、Bash の権限チェックとサンドボックスの不具合がまとめて修正されました。未知モデルの想定コンテキスト 1M 化など破壊的変更 20 件の対応も解説します。
音楽デジタルアーカイブとは?マスター音源を未来に残すユニバーサル ミュージックの取り組み|ユニバーサル ミュージック公式note
ユニバーサル ミュージックにおけるデジタルアーカイブおよびマスター音源の長期保存のための取り組みを紹介します。 音楽デジタルアーカイブとは 音楽デジタルアーカイブとは、アナログ・デジタルのマスター音源を長期保存し、将来活用可能な状態に維持する取り組みです。 ユニバーサル ミュージックが、アーティストたちと作り上げた楽曲や映像のマスターデータ。これらは録音技術の変遷とともに、さまざまなメディアに保存されています。その歴史を遡ると、レコードの金属原盤、アナログテープ、デジタルテープ、ハードディスクーーそして、現在はクラウドにアップされています。 クラウド上のデータは99.9%失われ
スーパーカセッターズ / SuperCassetters'
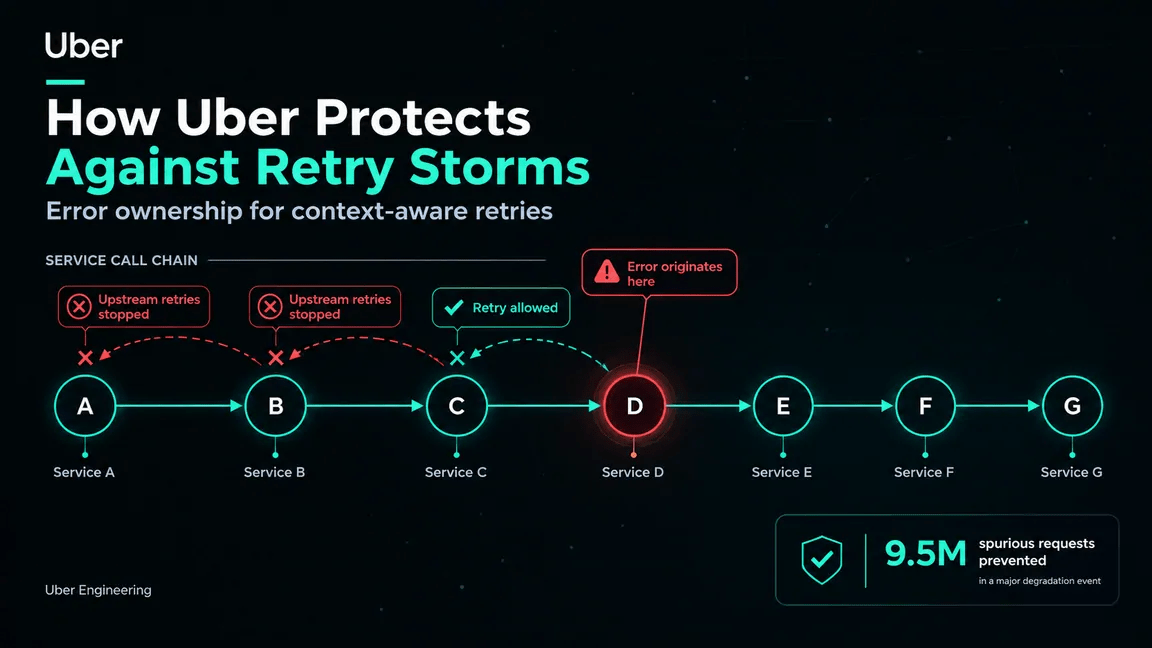
Uberはリトライストームからどのように身を守っているのか
Uberのエンジニアリングチームは、複雑に絡み合うサービス間依存関係を持つシステムで発生する「リトライストーム」現象によりビジネス運用やブランド信頼が受ける悪影響に対処するため、「エラーオーナーシップ」という概念に基づいたソリューションを開発・実装しました。このアプローチは、単一のサービス障害が連鎖的な障害を引き起こし、システム全体に波及する「ドミノ効果」を防ぐことを目的としています。
Node.jsのBrotli解凍の脆弱性CVE-2026-111497の仕組みを理解する:コードに書かなくても解凍は起きる | DevelopersIO
Node.js 22/24/26に同梱されたBrotliのデコーダーには、不正な圧縮データを「入力待ち」と誤判定し、内部バッファの外へ書き込む問題がありました。修正コミットから仕組みを読み解き、fetchやボディパーサーが自動で解凍する経路と、影響の確かめ方を整理します。
PHPの脆弱性をHacker Newsにリークした人物が「秘密だと知らなかった」と謝罪
ウェブサイトやウェブアプリの開発に広く使われているプログラミング言語「PHP」に深刻な脆弱(ぜいじゃく)性が見つかったことで、日本時間の2026年10月21日23時にセキュリティ更新プログラムおよび詳細情報が公開されることがアナウンスされ、多くのウェブサイトやサービスが緊急メンテナンス入りする騒動に発展しました。この件はもともと、PHPセキュリティチームがパッチを公開予定でしたが、ソーシャルニュースサイトのHacker Newsで脆弱性情報が漏えいしたため、前倒しになりました。これを投稿したユーザーがHacker Newsに再度登場し、「PHPの情報公開禁止について何も知らず、とんでもない形で裏目に出た」と騒動に対して謝罪しています。
俺が例えば強いアメコミオタクなのは資料をアホほど買ってアホほど読んでるからだけど、その背景にはそれを支える収入や時間の余裕が取れる環境があり、さらにその背景には学歴や出身地域のアドバンテージや、男性でなければ被っていたであろう社会的プレッシャーの数々から免れてるからでしょ
俺が例えば強いアメコミオタクなのは資料をアホほど買ってアホほど読んでるからだけど、その背景にはそれを支える収入や時間の余裕が取れる環境があり、さらにその背景には学歴や出身地域のアドバンテージや、男性でなければ被っていたであろう社会的プレッシャーの数々から免れてるからでしょ— キャプY:『タイタンズ:ビースト・ワールド』 (@Captain_Y1) June 28, 2020
GoogleとFacebookで「自分に関するすべてのデータ」を請求した結果
グーグルやフェイスブックの無料サービスを、私たちは日常的に使っている。だが、その「無料」の対価として、どれほどの個人データを提供しているかを実感する機会はほとんどない。実際にグーグルとフェイスブックへ情報開示を請求してみると、10年以上にわたる検索履歴や位置情報、行動記録までが詳細に保存されていた。ビッグテックは私たちのデータをどのように集め、広告収益へと変えているのか。その実態に迫る。※本稿は、朝日新聞編集委員の五十嵐大介『ルポ・シリコンバレー AIブームと米国社会の断層を歩く』(朝日新聞出版)の一部を抜粋・編集したものです。
